Ollama を GPU なしの VPS で動かす実測: 何 B のモデルまで実用か、n8n から呼ぶまで
国内 VPS は GPU がありません。それでも Ollama で小さなオープン LLM を CPU で動かし、常駐の要約・分類・ボットに使えるかを 4GB / 8GB で実測しました。インストール、Tailscale 内への公開、OpenAI 互換 API、n8n からの呼び出しまで。
本記事にはプロモーション (アフィリエイト広告) が含まれます。
「Ollama を VPS で」と検索する人は多いのに、実測を載せた記事が少ないので、先に結論を置きます。
国内の VPS には GPU がありません。それでも、月 2,480 円の 4GB VPS で 3B クラスのモデルが 1 秒に 40 トークン、1B なら 60 トークン出ました。 100 字の日本語なら 2〜3 秒です。私は「CPU では 1 秒に数トークル」と思い込んでいましたが、最近の VPS の CPU (AVX-512 対応) では桁が違います。上限を決めるのは速度ではなく メモリ で、4GB に n8n と Claude Code を同居させた状態では 3B が限界でした。
この記事では、その数字を実機で示します。4GB の VPS で 0.6B〜3B のモデルを動かして速度とメモリを測り、日本語の要約品質を比べ、n8n の Anthropic ノードを Ollama に差し替えて API 課金ゼロで動かすところまでやります。
Ollama とは
オープンなモデル (Llama、Gemma、Qwen、Mistral など) を、1 コマンドで取得して動かすためのツールです。
ollama run llama3.2:3bこれだけでモデルのダウンロードから対話まで始まります。裏では http://127.0.0.1:11434 に API サーバーが立っていて、OpenAI 互換のエンドポイントもあるので、OpenAI 用に書かれたクライアントの接続先を差し替えるだけで使えます。
この記事で使う環境
- VPS: XServer VPS クラウド 4GB (4 コア / NVMe 50GB)、Ubuntu 24.04。初期設定 と Tailscale 済み。同じ VPS で n8n と Claude Code が動いている状態 (使用メモリ 1.2〜1.3GB)
- CPU: AMD EPYC Genoa (Zen 4)、4 vCPU。
lscpuのフラグにavx512favx512_bf16avx512_vnniがあり、CPU 推論には有利な世代です - Ollama: 0.34.2。公式インストーラーで入れます (Docker は使わない。CPU 推論は素で動かす方が扱いやすい)
- 手元: Mac。Tailscale で VPS に繋がっている

メモリとモデルサイズの目安
量子化 (Q4) されたモデルは、パラメータ数の 0.6〜0.7 倍の GB をメモリに載せます。それに OS と他のサービスの分を足します。
| モデル | ファイルサイズ | 推論時のメモリ増分 |
|---|---|---|
| qwen3:0.6b | 0.5GB | 約 0.8GB |
| llama3.2:1b | 1.3GB | 約 1.2GB |
| qwen3:1.7b | 1.4GB | 約 1.6GB |
| llama3.2:3b | 2.0GB | 約 2.0GB |
4GB の VPS で他に何も動かしていなければ 3B〜4B、n8n や Claude Code と同居させるなら 3B が上限です。8B クラス (llama3.1:8b、約 5GB) は 8GB プランが要ります。
Gemma 4 は 12B からしかなく、4GB の VPS には載りません。「gemma4 を VPS で」と考えている人は、8GB でも足りず 16GB プランが要ります。小型モデルなら Llama 3.2 (1B / 3B) か Qwen 3 (0.6B / 1.7B / 4B) が選択肢です。
1. インストールと公開範囲の設定
curl -fsSL https://ollama.com/install.sh | sh>>> Installing ollama to /usr/local
>>> Creating ollama user...
>>> Creating ollama systemd service...
>>> Enabling and starting ollama service...
>>> The Ollama API is now available at 127.0.0.1:11434.
>>> Install complete. Run "ollama" from the command line.
WARNING: No NVIDIA/AMD GPU detected. Ollama will run in CPU-only mode.最後の WARNING が、この記事の前提そのものです。systemd のサービスとして入り、自動起動も有効になります。
初期状態では 127.0.0.1:11434 だけで待ち受けます。n8n のコンテナや手元の Mac から呼ぶには、待ち受けを広げます。インターネット側には出しません。 Ollama には認証がないので、公開したら誰でもモデルを使えてしまいます。
systemctl edit でも設定できますが、コメント行の下に書くと保存されずに破棄される (私はここで一度失敗しました) ので、ファイルを直接置く方が確実です。
sudo mkdir -p /etc/systemd/system/ollama.service.d
sudo tee /etc/systemd/system/ollama.service.d/override.conf <<'EOS'
[Service]
Environment="OLLAMA_HOST=0.0.0.0:11434"
EOS
sudo systemctl daemon-reload
sudo systemctl restart ollama
ss -tlnp | grep 11434
LISTEN 0 4096 *:11434 *:*0.0.0.0 にしていますが、初期設定の ufw は「SSH 以外を全部拒否」、Tailscale の記事で tailscale0 からは全部許可、にしてあるので、届くのは tailnet の中からだけです。n8n のコンテナからも呼ぶなら、n8n の記事の SSH と同じ理由で、Docker のネットワークからの許可を足します。
sudo ufw allow from 192.168.16.0/20 to any port 11434 proto tcp comment 'n8n container to ollama'手元の Mac から Tailscale 経由で届き、グローバル IP には届かないことを確認します。
curl -s http://100.96.34.27:11434/api/version{"version":"0.34.2"}グローバル IP に対して同じことをするとタイムアウトします。
2. モデルを取って動かす
ollama pull llama3.2:1b
ollama run llama3.2:1b --verbose
1.3GB のダウンロードに 2 分ほどかかりました。--verbose をつけると、応答の最後に速度が出ます。
total duration:       3.702585888s
load duration:        1.539583797s
prompt eval count:    175 token(s)
prompt eval duration: 606.15ms
prompt eval rate:     288.71 tokens/s
eval count:           96 token(s)
eval duration:        1.552345s
eval rate:            61.84 tokens/s
eval rate が生成速度で、「1 秒に何トークン出るか」です。日本語だと 1 トークンがおおよそ 1〜2 文字なので、61.8 t/s は 1 秒に 60〜120 字。人が読む速さより速いです。load duration はモデルをメモリに載せる時間で、初回だけかかります。
実測: モデルごとの速度とメモリ
同じプロンプト (日本語 200 字の文章を 2 行に要約) を、モデルごとに 3 回流しました。2 回目以降 (モデル読み込み済み) の値です。ホスト全体の使用メモリは、n8n と Claude Code が動いている状態 (推論前 1.3GB) からの数字です。
| モデル | サイズ | 生成速度 | 応答時間 | 使用メモリ (ホスト全体) |
|---|---|---|---|---|
| qwen3:0.6b | 0.5GB | 100 t/s | 2.7〜4.5 秒 | 2.1GB |
| llama3.2:1b | 1.3GB | 62 t/s | 1.3〜1.8 秒 | 2.5GB |
| qwen3:1.7b | 1.4GB | 55 t/s | 6〜8 秒 | 2.9GB |
| llama3.2:3b | 2.0GB | 39 t/s | 2.1〜2.2 秒 | 3.3GB |
見どころは 3 つです。
- 3B でも 39 t/s 出ます。100 字の要約が 2 秒で返るので、対話でも待たされる感じはありません。CPU が AMD EPYC Genoa (AVX-512 対応) なのが効いていると思います。古い世代の CPU や、AVX-512 のない VPS だと、ここまで出ないはずです
- qwen3 は「thinking」モードが既定で入る ので、応答時間が長く見えます (1.7B で 400 トークン超を出している)。要約のような定型処理では思考は不要なので、API で
"think": falseを渡すか、プロンプトの先頭に/no_thinkを置くと速くなります - 3B で 3.3GB に達しました。4GB プランで n8n と Claude Code を同居させた状態では、ここが上限です。スワップにはまだ落ちていませんが、余裕は 500MB ほどしかありません
日本語の品質
速度が出ても、日本語が崩れては使えません。同じ要約タスクで比べました (qwen3 は think なし)。
llama3.2:1b (84 トークン、3.5 秒)
VPS を契約した直後、root にパスワードでログインできます。作業ユーザーを作り、ssh の鍵認証だけを用いるし、ufw を閉じ、fail2ban を使用して総当たりを弾き、unattended-upgrades を自動化すれば、自分の鍵を持ってセキュリティを維持できます。
要点は拾えていますが、「用いるし」「ufw を閉じ」のように日本語が少し崩れます。分類やタグ付けのような、出力が短く形式が決まっている処理なら使えます。
llama3.2:3b (140 トークン、8.7 秒)
VPS を契約すると、すぐに世界中からログインが可能になるため、初期設定が大事です。以下のような準備をすると、セキュリティを強化できるようになります。
- 作業ユーザーを作成し、SSH を鍵認証のみにする
- SSH以外のポートを閉じる
- fail2ban を使用して総当たりを弾き、unattended-upgrades を使用してセキュリティ更新を自動化する
日本語は自然で、箇条書きまで整えてきます。ただし「2 行で」という指示を守っていません。
qwen3:1.7b (97 トークン、8.7 秒)
VPS契約後はrootパスワードでログイン可能だが、作業用ユーザーを作成し、SSHを鍵認証に変更し、ufwで他ポートを閉じ、fail2banで攻撃を弾き、unattended-upgradesでセキュリティ更新を自動化することで、セキュリティが確保できる状態にできる。この作業は約30分で完了する。
一番忠実です。要点を落とさず、指示にも従い、日本語も自然です。4GB の VPS で要約や整形をさせるなら、qwen3:1.7b を think なしで使うのが本命 だと思います。
メモリが足りないとスワップに落ちて、速度が 1/10 以下になります。「動くけど使い物にならない」状態です。上の表で自分の環境に収まるモデルを選んでください。8B クラスを動かしたいなら 8GB プランです。
常駐させるかどうか
Ollama は、使われないモデルを 5 分でメモリから降ろします。次のリクエストで再読み込みするので、初回だけ数秒〜数十秒余計にかかります。定期実行の用途ならこのままで構いません。常にメモリに置きたいなら OLLAMA_KEEP_ALIVE=-1 を systemd の環境変数に足します。ただし他のサービスとメモリを奪い合うので、4GB で n8n や Claude Code と同居させるなら降ろす方が安全です。
3. API で呼ぶ
Ollama 自身の API と、OpenAI 互換 API の 2 つがあります。既存のツールと繋ぐなら後者が楽です。
curl http://100.x.y.z:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemma4:4b",
    "messages": [
      {"role": "system", "content": "与えられた文章を 1 行で要約する。"},
      {"role": "user", "content": "(ここに文章)"}
    ]
  }'
OpenAI の SDK なら、base_url を http://100.x.y.z:11434/v1 に、api_key を適当な文字列にすれば、そのまま動きます。
4. n8n から呼ぶ
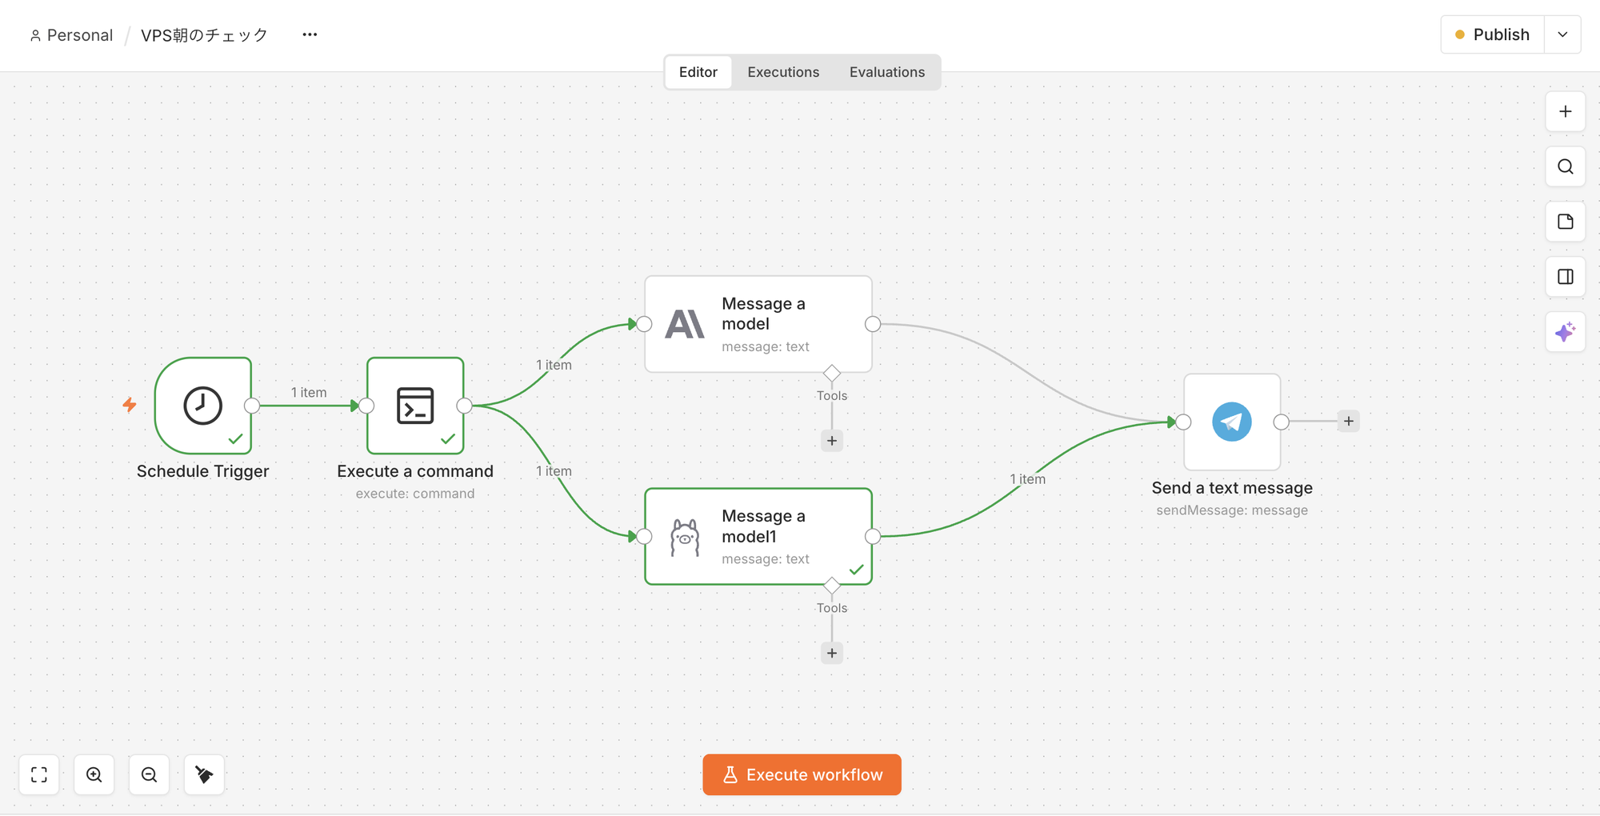
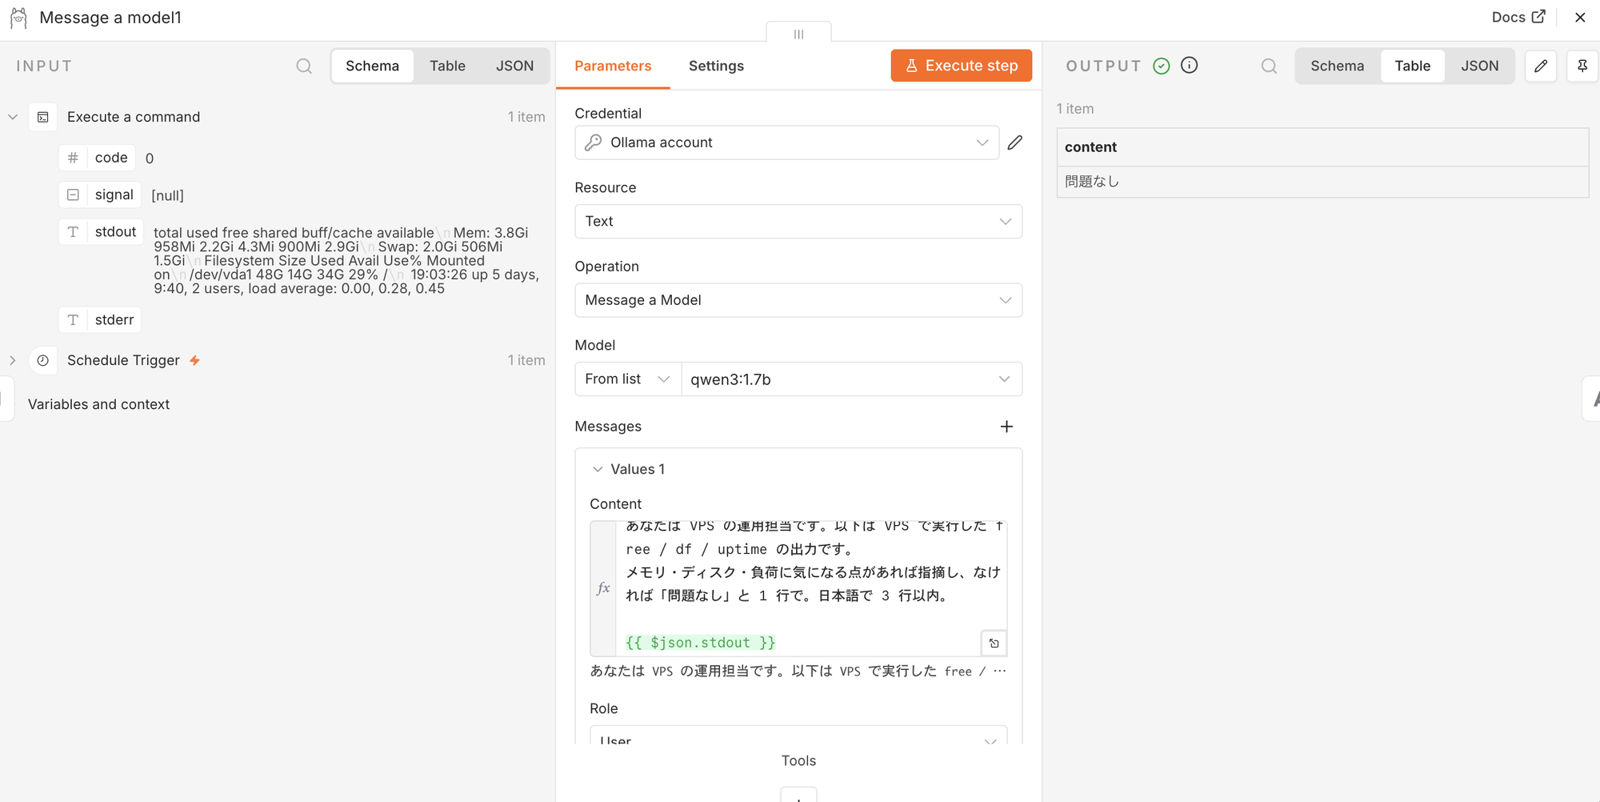
n8n には Ollama ノードがあり、n8n の記事で使った Anthropic ノードと同じ構造 (Message a Model) です。Credential を新規作成して Base URL に http://100.96.34.27:11434 (VPS の Tailscale IP) を入れ、Model に qwen3:1.7b を選ぶだけで、プロンプトはそのまま使えます。
「毎朝 VPS の状態を要約して通知」のワークフローに、Anthropic ノードと並列で Ollama ノードを足して、同じ入力 (free / df / uptime の出力) を両方に流しました。
Claude と Ollama の返答を並べる
同じ入力に対する返答です。この日のディスクは 29% (Ollama のモデルを 4 つ入れた直後)、メモリは 2.9GB 空き、スワップが 506MB 使われている状態でした。
qwen3:1.7b (Ollama、API 課金なし)
問題なし
claude-sonnet-5 (Anthropic API)
- メモリ・ディスク・負荷ともに余裕があり健全です (available 2.9Gi、Disk 使用率 29%、load average 1.0 未満)。
- ただしメモリに余裕があるにもかかわらず Swap が 506Mi 使用されている点は少し気になります。vm.swappiness 設定の確認を推奨します。
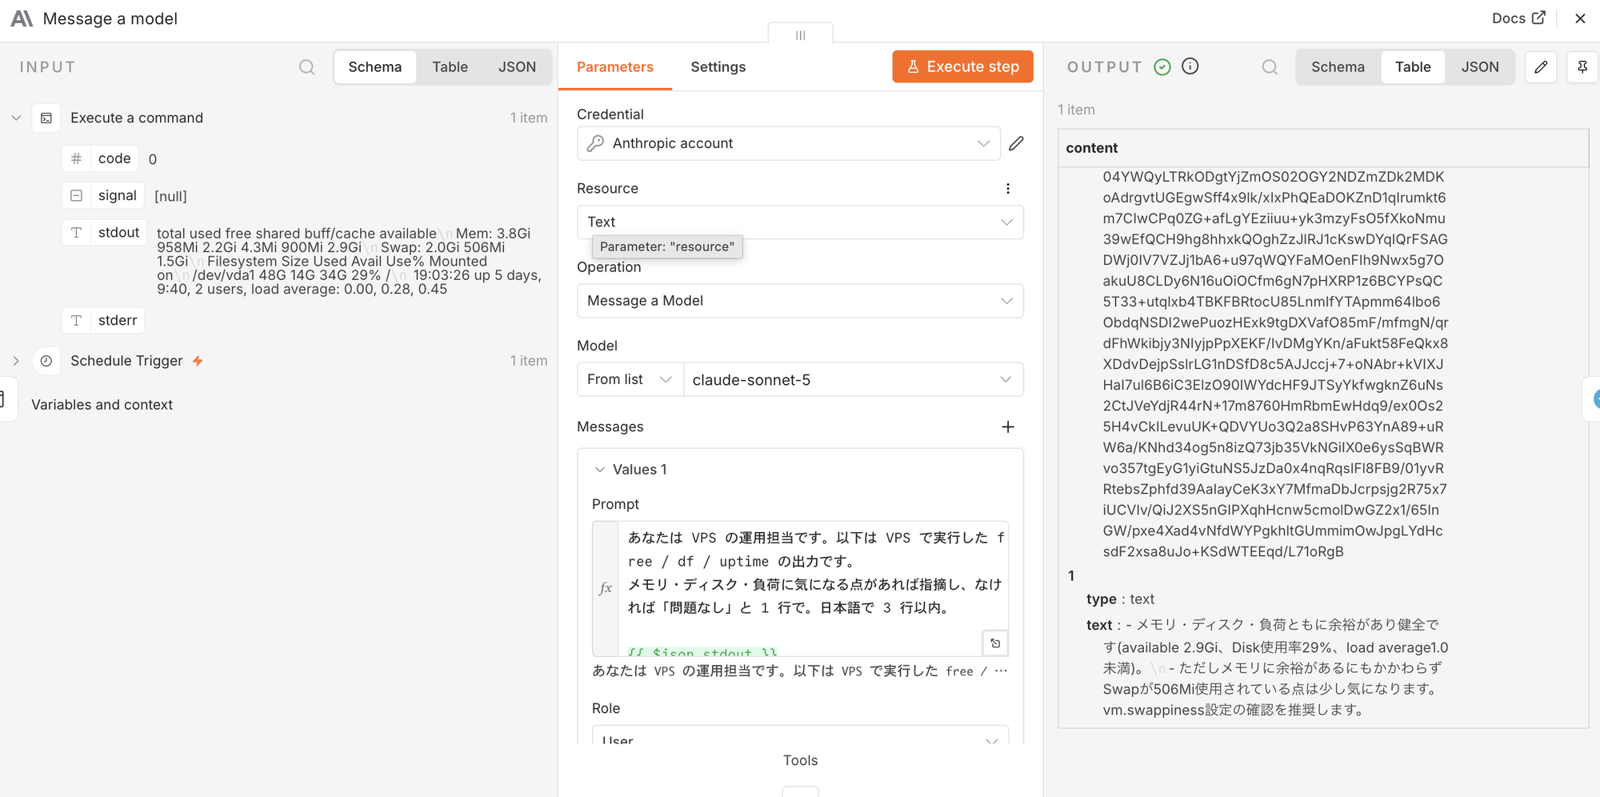
差は明らかです。qwen3 は各数値が閾値の範囲内かを見て「問題なし」と言いました。Claude は「メモリが空いているのにスワップが使われている」という 数値の間の矛盾 に気づき、原因の候補まで挙げています。実際、このスワップは直前のベンチマークで 3B モデルを載せたときに押し出されたものなので、指摘は正しいです。
「異常があったら教えて」という用途では、この差が本質です。閾値を超えたかどうかの判定なら Ollama で十分ですが、「何かおかしい」を見つけるのは Claude の方が圧倒的に上です。
向いている処理、向いていない処理
1.7B〜3B クラスのモデルに向いているのは、入力も出力も短く、正解がだいたい決まっている処理です。
- ログやメールの分類 (「エラー / 警告 / 情報」のどれか)
- 短い文章の要約、タイトル付け
- 定型フォーマットへの整形 (JSON にする、など)
- 決まった質問への一次回答
向いていないのは、長い文脈の理解、数値の間の関係を見る判断、推論が要る判断、コード生成です。そこは Claude に投げる方が結局安くつきます。私の朝のチェックは、当面この並列の形 (Telegram に 2 通届く) で動かして、両者の返答を毎日見比べることにしました。1 日 1 回なら Claude 側は月に数円ですし、どこで差が出るかを観察したいからです。
5. 費用: Anthropic API と比べる
正直な比較です。朝のチェック 1 回は、入力 (プロンプト + free / df / uptime の出力) が 300 トークン、出力が 150 トークンほどでした。claude-sonnet-5 の単価は入力 $2 / 出力 $10 (100 万トークンあたり) なので、1 回 0.002 ドル、月 30 回で 0.06 ドル (約 9 円) です。
| Ollama (XServer VPS クラウド 4GB) | Anthropic API (claude-sonnet-5) | |
|---|---|---|
| 固定費 | 月 2,480 円 (VPS 代。他の用途と共用) | 0 円 (前払いクレジット 5 ドル〜) |
| 朝のチェック 1 日 1 回 | 0 円 | 月 9 円 |
| 短い要約 1 日 100 回 | 0 円 | 月 300 円 |
| 品質 | 閾値の判定はできる。矛盾には気づかない | 数値の間の関係を見て指摘してくる |
| 応答時間 (100 字) | 2〜3 秒 | 3〜5 秒 |
| データの行き先 | VPS の中 | Anthropic |
お金だけなら Anthropic API の方が安い です。VPS を Ollama のためだけに借りるなら、月 2,480 円で API を 800 回以上呼べます。Ollama を選ぶ理由は、既に VPS があって空きメモリを使うだけなこと、データを外に出さないこと、回数を気にせず回せること、そして「自分のモデルを動かしている」こと自体です。次の記事で扱う、自分で学習させたモデルを動かす、という遊びもこの延長にあります。
私は当面、朝のチェックを Claude と Ollama の両方で動かして返答を見比べ、Ollama は「データを外に出したくない処理」と「試行回数が多い処理」に寄せていく、という進め方にしました。
つまずいた点
- 「CPU は遅い」という思い込み。記事の初稿では「1 秒に数トークン」と書いていました。実測は 1B で 60 t/s、3B で 40 t/s。AVX-512 対応の CPU なら、対話でも待たされない速さです。古い認識で書かなくてよかったです
- gemma4 が載らない。Gemma 4 は 12B からで、4GB どころか 8GB でも無理でした。「gemma4 を VPS で」と考えている人は、モデルのサイズ展開を先に確認してください
systemctl editで設定が消えた。コメント行の下に書いてしまい、保存されずに破棄されました。override.confをteeで直接置く方が確実です- qwen3 の thinking。既定で思考モードが入り、要約に 400 トークンも使っていました。
think: falseで切ると、速度も品質も本来の値になります - n8n のコンテナから届かない。SSH のときと同じで、ufw に Docker のネットワークからの許可が要りました。11434 番も同じルールを足します
- スワップに気づいたのは Claude だった。ベンチで 3B を載せた後、スワップが 500MB 使われている状態を、Ollama は「問題なし」、Claude は「メモリが空いているのにスワップがあるのはおかしい」と指摘しました。比較のつもりが、Claude の方の価値を確認する結果になりました
インストールから 4 モデルの実測、n8n での Claude との比較まで、全部で 1 時間ほどでした。
次にやること
- 自分のブログ記事を学習させたモデルを作り、この VPS で動かす (Colab の無料枠 + Unsloth で LoRA → GGUF → Ollama)。準備中
- n8n の定型処理を Ollama に寄せて、Claude は判断が要るところだけに使う
- 8B クラス (llama3.1:8b) を動かすなら 8GB プランへ。XServer VPS クラウドは上位プランへの変更ができるので、必要になってからで間に合います
まとめ
- GPU なしの VPS でも Ollama は動く。AVX-512 対応の CPU なら 1B で 60 t/s、3B で 40 t/s と、対話でも困らない
- 上限を決めるのはメモリ。4GB に n8n と Claude Code を同居させると 3B まで。8B は 8GB プラン
- 日本語の要約なら qwen3:1.7b を think なしで使うのが本命。llama3.2:1b は日本語が少し崩れる
OLLAMA_HOSTを広げるが、届くのは Tailscale の中だけ。Ollama に認証はない- n8n の Ollama ノードは Anthropic ノードと同じ構造。Credential と Model を差し替えるだけ
- 「異常に気づく」のは Claude の方が圧倒的に上。閾値判定なら Ollama、矛盾の発見なら Claude
- お金だけなら Anthropic API が安い (朝のチェックで月 9 円)。Ollama を選ぶ理由はデータの置き場所と回数制限のなさ