Claude Code の CLAUDE.md と memory の書き方: 置き場所、@import、auto memory との違い、記憶を育てる 5 つのルール
CLAUDE.md の置き場所と読み込み順、@import の仕様、auto memory との違いを公式ドキュメントで整理し、VPS の常駐エージェントで 3 日回して分かった「記憶が育つ書き方」をまとめました。skill が自分で直った実例と、間違いを覚えたときの直し方まで。
本記事にはプロモーション (アフィリエイト広告) が含まれます。
「CLAUDE.md に何を書けばいいのか」「auto memory があるのに CLAUDE.md は要るのか」で調べている人向けに、先に結論を置きます。
CLAUDE.md は「あなたが書く指示」、auto memory は「Claude が書くメモ」です。 どちらも毎回のセッション開始時に読まれます。CLAUDE.md には役割とルールを書き、auto memory は放っておけば Claude が育てます。ここまでは公式ドキュメントの通りです。
この記事で足したいのはその先です。私は VPS に常駐させた Claude Code を「長く動かすほど賢くなる」エージェントにしようとして、CLAUDE.md に 記憶のルール を書きました。事実・手順・履歴の 3 層に分け、「いつ書くか」「どう直すか」まで決めます。3 日動かしたところ、手順書 (skill) が自分の間違いに 2 回気づいて自分で直り、私が教えた訂正も 3 か所に正しく反映されました。そのとき効いた書き方を、5 つのルールにまとめます。
この記事で使う環境
- Claude Code 2.1.280 (公式ドキュメントの仕様は 2026-09-23 時点)
- 実例は、VPS に常駐させた Claude Code のエージェント「iris」。XServer VPS クラウド 4GB、Ubuntu 24.04。構成は 記事 12
- モデルは途中から Claude Opus 5.5。Claude Pro の契約枠で動かしている

CLAUDE.md とは: 置き場所と読み込み順
Claude Code のセッションは、毎回まっさらな状態で始まります。CLAUDE.md は、その最初に必ず読まれる Markdown ファイルです。置き場所は 4 種類あり、広い方から順に読まれます (公式ドキュメント、2026-09-23 確認)。
| 範囲 | 場所 | 使いどころ |
|---|---|---|
| 組織 | /etc/claude-code/CLAUDE.md (Linux) |
会社のポリシー。IT 部門が配る |
| ユーザー | ~/.claude/CLAUDE.md |
全プロジェクト共通の自分の好み。口調、言語、よく使うツール |
| プロジェクト | ./CLAUDE.md または ./.claude/CLAUDE.md |
そのリポジトリのルール。git で共有する |
| ローカル | ./CLAUDE.local.md |
そのリポジトリでの自分だけのメモ。.gitignore に入れる |
ポイントは 3 つです。
- 上書きではなく連結。全部が順に並べて読まれます。後から読まれる (作業ディレクトリに近い) ものほど、実質的に優先されます
- 親ディレクトリも読む。
~/work/app/で起動すると、~/work/CLAUDE.mdも読まれます - 子ディレクトリは遅延読み込み。
app/api/CLAUDE.mdは、Claude がapp/api/のファイルを読んだときに初めて入ります
どれが読まれているかは、セッション内で /context を打つと「Memory files」の下に一覧が出ます。「書いたのに効かない」ときは、まずここを見てください。
サイズの目安は 1 ファイル 200 行以内 です。長いほど文脈を圧迫し、指示が守られにくくなると公式にあります。
@import: 他のファイルを取り込む
CLAUDE.md の中に @パス と書くと、そのファイルが展開されて一緒に読まれます。
@memory/MEMORY.md
@skills/INDEX.md
仕様は次の通りです。
- 相対パスは CLAUDE.md の場所からの相対。作業ディレクトリからではない
- 取り込んだ先でさらに
@を書ける。4 段まで - バッククォートやコードブロックの中の
@は取り込まない。パスを説明したいだけなら`@README`と囲む - 作業ディレクトリの外 (ホームなど) を指す
@は、初回に承認ダイアログが出る
注意点は、取り込んだファイルも起動時に全部読まれる ことです。分割しても文脈の量は減りません。整理のための機能であって、節約の機能ではありません。量を減らしたいなら、「索引だけ取り込み、本体は必要なときに開かせる」書き方にします (後で iris の例を見せます)。
auto memory との違い: 「memory vs CLAUDE.md」の答え
Claude Code には、CLAUDE.md とは別に auto memory という仕組みがあります。既定でオンです。
| CLAUDE.md | auto memory | |
|---|---|---|
| 誰が書く | 人 | Claude |
| 中身 | 指示とルール | 学んだこと、あなたの好み、訂正 |
| 場所 | 上の表の 4 か所 | ~/.claude/projects/<プロジェクト>/memory/ |
| 読まれる量 | 全部 (200 行以内推奨) | 索引 MEMORY.md の先頭 200 行か 25KB まで |
| git 管理 | できる (プロジェクト内) | しない (ホーム配下、マシンごと) |
auto memory は MEMORY.md を索引にして、1 つの記憶を 1 ファイルに書きます。種類は user (あなたのこと)、feedback (訂正と、うまくいったやり方)、project (進行中の仕事)、reference (外部の情報のありか) の 4 つです。「覚えておいて」と頼むとここに入ります。CLAUDE.md に書いてほしいときは「CLAUDE.md に足して」と明示します。
では、CLAUDE.md だけで十分か、auto memory だけで十分か。私の答えは 「日常の開発なら auto memory に任せる。エージェントとして育てたいなら、記憶のルールを CLAUDE.md に自分で書く」 です。理由は auto memory の仕様にあります。
- 手順を覚えない。公式に「コードから分かること、デバッグの修正内容は保存しない」とあります。エージェントに必要な「この作業はこうやる、ここでつまずく」がまさにそれです
- いつ書くかは Claude 任せ。「毎回保存するわけではない。将来役立つかで判断する」とあります
- git の外にある。何をいつ覚えたか、差分で追えません。間違いを覚えたときに気づきにくい
auto memory は「CLAUDE.md に書いてあることは保存しない」仕様です。私の常駐エージェントは CLAUDE.md に記憶のルールを書いているので、auto memory の側には 3 日間で何も書かれませんでした。二重に管理される心配はありません。
記憶を育てる 5 つのルール
ここからが本題です。私の常駐エージェント iris の CLAUDE.md (51 行) から、効いた書き方を抜き出します。全体の構成は 記事 12 にあります。
ルール 1: 目指す姿を 1 行で書く
目指す姿: **学んだことを記憶し、長く動かすほど能力が高まる。**
同じことを 2 度聞かれたら 2 度目は速く、同じ作業を 2 度やったら 2 度目は失敗しない。
「記録して」だけだと、Claude は記録すること自体を目的にします。何のために記録するかを書くと、「この失敗は次に効くから skill に書こう」という判断ができるようになります。2 行目の「2 度目は失敗しない」が、後で見る自己修正の動機になっていました。
ルール 2: 記憶を 3 層に分ける
| 層 | 場所 | 何を書くか | いつ読むか |
|---|---|---|---|
| 事実 | `memory/MEMORY.md` | crz33 のこと、環境、方針、好み | 毎回 (下で自動読込) |
| 手順 | `skills/<名前>.md` | 一度やった作業のやり方、つまずき | 該当する作業のとき |
| 履歴 | `notes/YYYY-MM-DD.md` | 何を聞かれ、何を答えたか | 過去を探すとき |

@memory/MEMORY.md
@skills/INDEX.md
1 つのファイルに全部書くと、すぐに 200 行を超えます。読む頻度で分ける のがコツです。
- 事実 は毎回要るので
@で取り込む。1 行 1 事実で短く保つ - 手順 は索引 (
INDEX.md) だけ取り込み、本体は該当する作業のときに開かせる。skill が 20 本に増えても、毎回読むのは 20 行 - 履歴 は取り込まない。「前にやった気がする」ときに
grep -r notes/で探させる
2026-09-26 に、iris の手順書 (skills/) を Claude Code 公式のスキル (.claude/skills/<名前>/SKILL.md) に移しました。索引の INDEX.md はなくなっています。移した理由と前後の比較は「Claude Code のスキルの作り方」に書きました。
この分け方は、Hermes Agent の memory / skills / session_search と同じです。
ルール 3: 「いつ書くか」を書く
## 学習のループ (毎回やる)

会話や作業が一区切りついたら、頼まれなくても次の 3 つを自問して書く。
書いたら `git add -A && git commit -m "<層>: <一言>"` まで行う。

1. 事実が出てきたか → `memory/MEMORY.md` に 1 行追記
2. 手順として残せるか → `skills/<名前>.md` を書くか更新。失敗したときこそ書く
3. 必ず → `notes/YYYY-MM-DD.md` に要点を追記

作業を始める前は、逆にこの順で読む。
「前にやったことがある気がする」ときは必ず探す。
一番効いたのがこの節です。「頼まれなくても」「一区切りついたら」「commit まで」の 3 つがないと、Claude は答えるだけで終わります。書いてからは、ほぼ毎回の会話の最後に「Appended note and committed」と出るようになりました。
「失敗したときこそ書く」も重要です。成功した手順はコードや履歴から再現できますが、なぜ失敗したかは書かないと消えます。
ルール 4: 書式を決める
## 記憶の書き方

- 1 行 1 事実。長い説明は書かない。根拠になった日付を末尾に `(2026-09-21)` と付ける
- 一時的なこと (今日の作業の途中経過、やることリスト) は memory に入れない。notes に書く
- skill は「目的 / 手順 / つまずいた点 / 確認方法」の 4 節。コマンドはコピペで動く形
日付は、後で「この事実はいつの話か」を判断する材料です。環境は変わるので、古い事実は疑う必要があります。skill の 4 節は、特に「つまずいた点」の欄があることで、失敗が書き込まれる場所ができます。
ルール 5: 直すルールを書く
- 既にある行と矛盾したら古い方を直す
- 使った skill に間違いや古い情報があれば、その場で直す。直したら commit記憶は増やすだけだと腐ります。使った瞬間に直す のが一番安く、正確です。使っているときこそ、それが正しいかを一番よく分かっているからです。
3 日動かして、何が育ったか
iris を 9/21 から 3 日動かしました。学習の履歴は git に残っています。
cd ~/iris && git log --format="%ad %s" --date=format:"%m-%d" -- memory skills09-23 skills: SSH ログイン失敗の二重計上を訂正 (Failed password のみ数える)
09-23 skills: server-health の SSH 確認を auth.log で行う形に
09-23 skills: server-health の SSH ログ確認を修正
09-23 memory: FX自動売買プロジェクトを追記
09-22 memory: Gmail検索の限界を方針に追記
09-22 skill: コネクタ有効化の手順、Gmail 連携完了を記録
09-22 記憶を 3 層 (memory / skills / notes) にして学習のループを CLAUDE.md に書くmemory の事実は 7 行から 12 行に、skill は 1 本から 2 本になりました。server-health は 3 回書き換わっています。中身を 3 つ見ます。
例 1: 初めての作業が skill になった
Gmail のコネクタを繋いだとき、claude.ai 側で接続したのに iris からは使えませんでした。原因は、ツールの一覧がセッションの起動時に読まれることで、再起動が必要でした。iris はこの経緯を、頼まれずに skill にしました。
# コネクタ (Gmail など) を有効化する

## 手順
1. crz33 が claude.ai の設定 → コネクタ で対象を「連携」する (iris はできない)
2. 連携後、`bin/restart` を実行する。これをやらないと新しいツールは出てこない
3. 再起動後、`ToolSearch` で該当ツール名を検索して使えるか確認する

## 週次レビューで、notes が memory と skills に昇格した

iris には、毎週土曜 5:00 に「notes を読み返して、memory と skills に昇格させる」週次レビューを cron で動かしています (仕組みは [記事 12](/vps/claude-code-agent-iris/))。会話のたびの学習ループが「その場で書く」なら、週次レビューは「まとめて整理する」係です。Hermes Agent の curator (記憶の整理役) に当たります。

初回の 2026-09-26 の実行で、3 日分の notes から次のものが昇格しました。

```bash
cd ~/iris && git show --stat HEAD~1 --format="%s"
memory/skills: 週次レビュー 2026-09-26 (Gmail 整理の skill、方針 2 行、事実 2 行、server-health の時刻の説明を修正)
memory/MEMORY.md | 4 ++++
skills/INDEX.md | 1 +
skills/gmail-cleanup.md | 21 +++++++++++++++++++++
skills/server-health.md | 2 +-- 方針が 2 行: 「数千件の Gmail の一括操作は、Gmail の画面でやってもらう」「ログの件数は 1 イベント 1 行で数える」。どちらも、会話の中で失敗して訂正された経験から来ています。後者は、SSH の失敗を二重に数えた一件そのものです
- 事実が 2 行: Gmail の使い方 (アーカイブで運用している) と、別に進めている FX ボットの前提 (数分〜数時間のトレンドフォロー、米ドル/円)
- skill が 1 本:
gmail-cleanup.md。広告の整理、一括削除、「なぜ受信トレイにないのか」の調べ方。Gmail の整理を何回かに分けてやった notes から、手順として 1 本にまとめています - skill の修正が 1 つ:
server-health.mdの中の時刻の説明に矛盾があったのを直しています
memory は 13 行から 17 行に、skill は 2 本から 3 本になりました。notes に書いた一回きりの出来事が、「次も使う方針」と「次も使う手順」に変わっています。ルール 3 の「失敗したときこそ書く」で notes に残った失敗が、週次で方針に格上げされる、という流れがうまく回りました。
1 つ課題も見えました。週次レビューが出した記事候補の 1 つ (「SSH 総当たり 1 万件と auth.log の数え方」) は、私がすでにブログの別の記事に追記した内容でした。iris にはブログの記事一覧を送っていますが、タイトルだけなので、記事に後から足した中身までは分かりません。記憶を渡すときは、何を渡していないかも意識する必要があります。
つまずいた点
- 連携直後は
ToolSearchで探しても出てこない。原因は反映漏れではなく再起動が必要なだけ (2026-09-22)
次に Calendar や Drive を繋ぐときは、このファイルを読めば 1 回で済みます。ルール 3 の「失敗したときこそ書く」がそのまま効いています。

### 例 2: 判断ミスが「方針」になった

Gmail で「このメールはなぜ受信トレイにないのか」と聞いたとき、iris は「フィルタで最初からスキップしている」と推測で答えました。実際は私が自分でアーカイブしていただけです。iris はこの誤りを notes に書き、原因を分析して memory の「方針」に 1 行足しました。

```markdown
## 方針
- Gmail 検索結果は「今のラベル状態」のスナップショットに過ぎず、履歴 (いつアーカイブされたか等) の
証拠にはならない。断定する前にこの限界を意識する (2026-09-22)事実でも手順でもなく、考え方の癖の修正 が memory に入りました。memory は毎回読まれるので、次に Gmail を調べるとき、iris はこの限界を知った状態から始まります。
例 3: skill が自分の間違いに 2 回気づいた
最初に私が書いた skill server-health.md には、SSH のログイン失敗を数える次の行がありました。
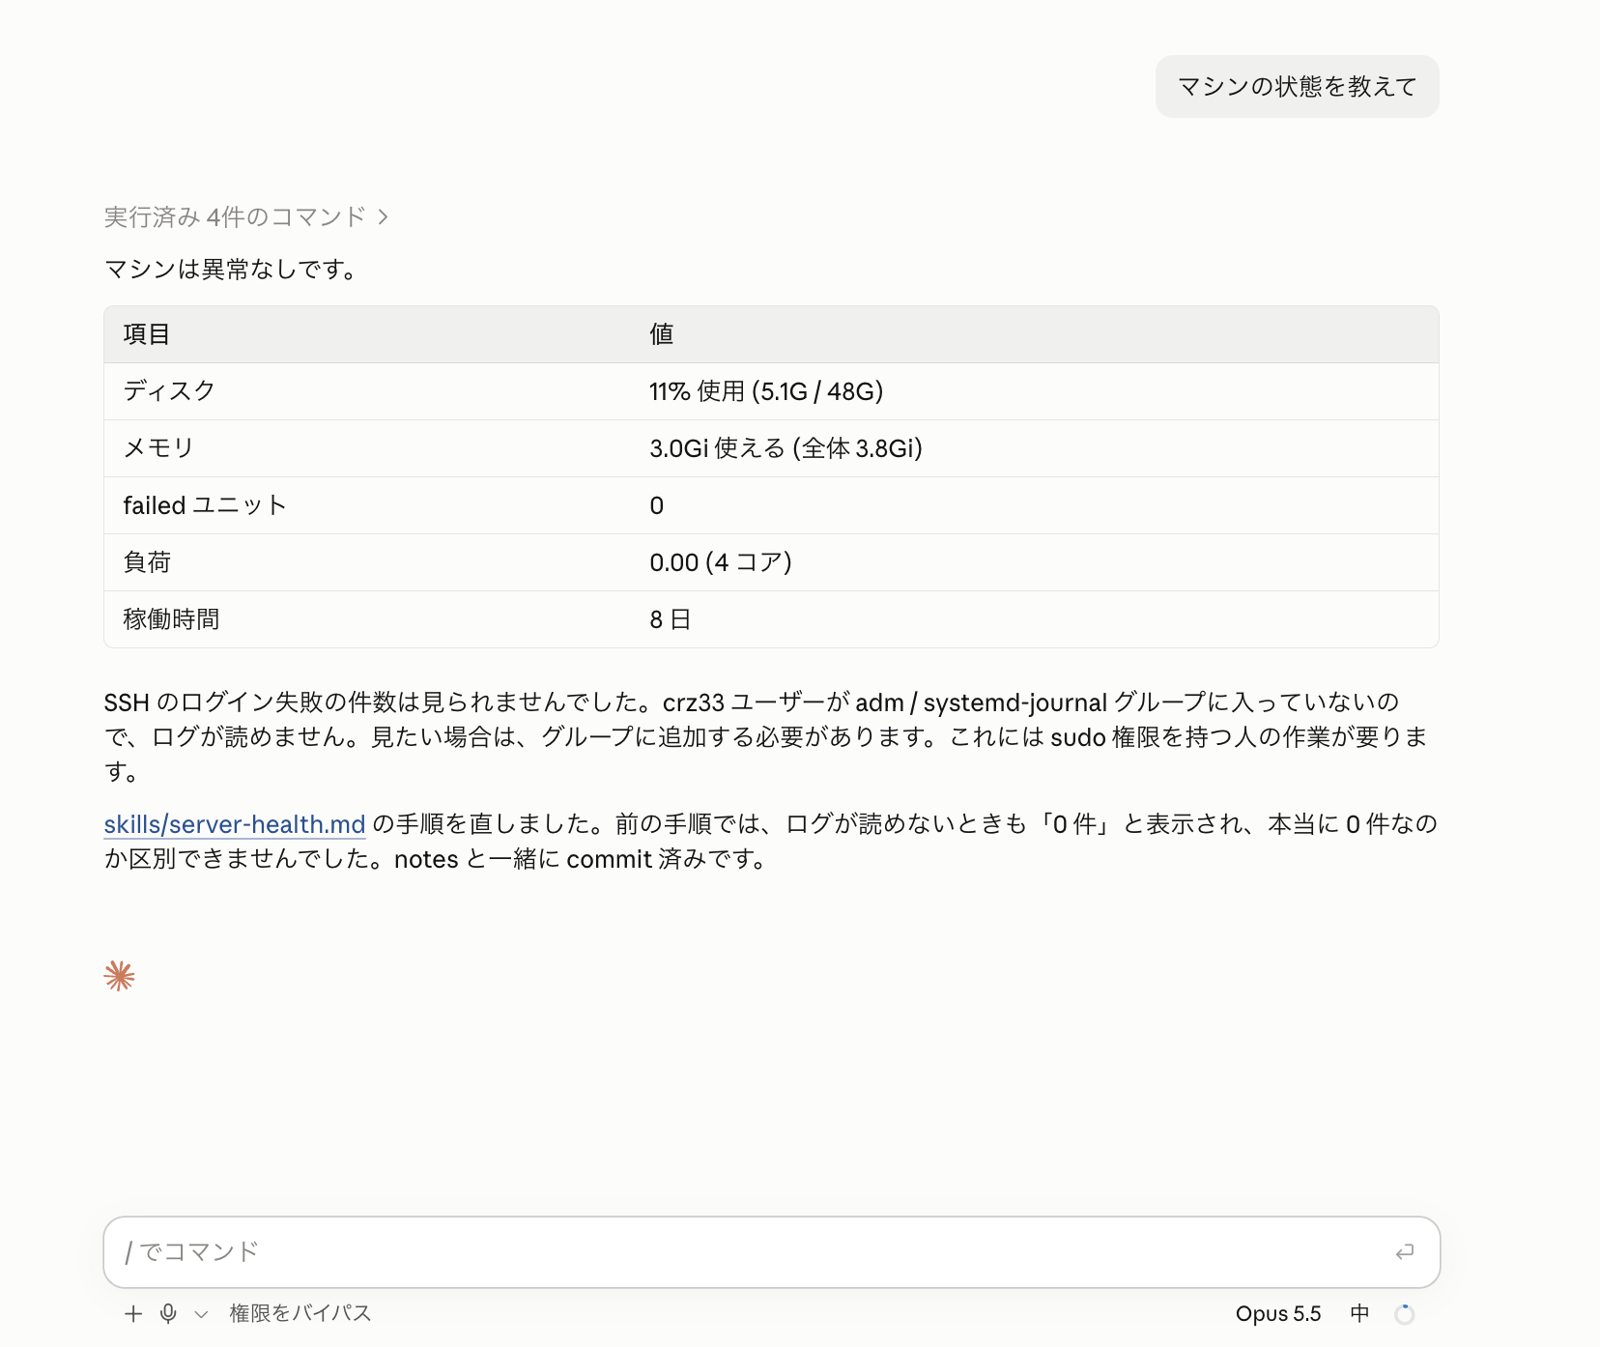
journalctl -u ssh --since "24 hours ago" --no-pager 2>/dev/null | grep -c "Failed password" || echo 0「マシンの状態を教えて」と頼んだとき、iris はこの skill を使い、欠陥に気づきました。権限がなくてログが読めないのに、2>/dev/null で黙らせて「0」と表示されてしまう。読めないのか本当に 0 件なのか区別できない という欠陥です。iris は skill を直して commit し、私に「ログを読むには adm グループが要る」と報告しました。
私が sudo usermod -aG adm crz33 で権限を足すと、次の質問で iris はもう一度 skill を直しました。今度は journalctl ではなく /var/log/auth.log を読む形です。前回の報告「adm に入っていない」が誤りだったことも、id を打って確かめてから訂正しています。
## つまずいた点
- `journalctl -u ssh` は「Hint: You are currently not seeing messages...」が出て読めない。
  crz33 は adm グループなので `/var/log/auth.log` を読む (2026-09-23 確認)
- 旧手順の `grep -c ... || echo 0` は 0 件だと「0」が 2 行出て紛らわしかった
ルール 5 の「使った skill に間違いがあれば、その場で直す」がそのまま起きています。私が書いた手順を、使いながら Claude が直していく。これが「長く動かすほど賢くなる」の実体です。
間違いも覚える: 訂正の流し方
ただし、記憶は間違いも覚えます。例 3 の後、iris は SSH の失敗を「9/14 に 20,382 件」と報告し、notes と memory と skill に書きました。これは二重計上です。1 回のパスワード試行が、sshd の Failed password と PAM の authentication failure など複数の行に記録されるので、パターンを OR で足すと件数が膨らみます。正しくは Failed password だけを数えて 9,753 件でした。
間違った数字が memory に入ると、以後のすべての会話がそれを前提にします。放っておけません。私は訂正を 1 回、普通の言葉で伝えました。
cd ~/iris && claude -p "訂正です。9/23 に SSH ログイン失敗を 09-14 20,382 件と報告し、notes と memory と skills に残しましたが、二重計上でした。(中略) 正しくは「Failed password」だけを数えて 09-13 349 件、09-14 9,753 件です。学習のループに従って直して、何を直したかを 3 行で報告して"3 か所を直して commit しました (b4670ec)。件数はこちらでも数え直し、349 / 9,753 / 計 10,102、最後の失敗 09-14 20:00:51 で一致しました。
1. skills/server-health.md: 数えるコマンドを grep "Failed password" だけに変えました。「OR で数えると二重計上になる」ことと、今回の誤報告の数値を「つまずいた点」に書きました。
2. memory/MEMORY.md: 正しい件数と最後の失敗時刻を 1 行足しました。(略)
3. notes/2026-09-23.md: 13:12 の誤った数値を打ち消し線で消し、正しい数値を並べました。効いたのは 3 点です。
- 「学習のループに従って」と言うだけで、3 層すべてに伝播した。どこに何を書くかを私が指定する必要はありませんでした
- 鵜呑みにせず数え直した。私の訂正が正しいかを自分でコマンドを打って確かめ、一致してから直しています
- notes は消さずに打ち消し線。履歴は「何を間違えたか」も含めて残す。memory と skill は正しい状態に直す。層ごとに直し方が違うのは、ルール 2 の分け方が効いています
訂正に気づけたのは、memory と skill がプロジェクトの中のただのファイルで、記事を書くために開いて読んだからです。直した後の差分も git で確かめられます。auto memory のようにホームの奥にあると、開いて読む機会が少なく、見過ごしやすいと思います。
つまずいた点
@importしても文脈は減らない。最初は memory と skills を丸ごと@で取り込もうとしました。取り込んだファイルは起動時に全部読まれるので、分割しても量は同じです。skills は索引だけを取り込む形に変えました- CLAUDE.md を変えても、動いているセッションには効かない。CLAUDE.md は起動時に読まれます。常駐させている場合は、再起動するか新しいセッションを開きます。memory や skill の中身は Claude がその場で読み書きするので、こちらは再起動不要です
- 「記録して」だけでは記録しない。最初の版は「会話が一区切りついたら notes に書く」だけでした。memory と skill には何も書かれず、notes だけが増えました。「3 つを自問する」とチェックリストにしてから、3 層に書き分けるようになりました
- 間違いも覚える。二重計上の件数が 3 か所に入りました。記憶は git で管理して、ときどき差分を読んでください
- auto memory と混ざる心配。最初は二重管理になるかと思いましたが、CLAUDE.md に書いてあることは auto memory が保存しない仕様で、問題は起きませんでした
次にやること
- 週次レビューを 1 か月回して、memory が 200 行に向かってどう増えるか、古い行がちゃんと直されるかを見る
- memory が 200 行に近づいたら、トピックごとにファイルを分ける。auto memory と同じ「索引 + 本体」の形に寄せる
- 同じルールを、手元の Mac の開発用プロジェクトにも入れる。エージェントでなくても「失敗したときこそ書く」は効くはず
まとめ
- CLAUDE.md は人が書く指示、auto memory は Claude が書くメモ。どちらも毎回読まれる
- 置き場所は組織・ユーザー・プロジェクト・ローカルの 4 つ。上書きではなく連結。
/contextで確認できる @importは整理のための機能。取り込んだファイルも全部読まれる。量を減らすなら索引だけ取り込む- 日常の開発なら auto memory で足りる。エージェントとして育てるなら、記憶のルールを CLAUDE.md に書く
- 5 つのルール: 目指す姿を 1 行で / 事実・手順・履歴の 3 層 / いつ書くかを書く / 書式を決める / 直すルールを書く
- 3 日で skill が 2 回自分で直り、判断ミスが方針になった。間違いも覚えるので、git で差分を見る